Waar mag een AI schrijven? De architectuur achter Leja
Hoe we een AI-kennispartner hebben ingericht die leest wat nodig is, alleen via een mens in productiedata schrijft, en op een eigen server draait. Met de techniek erbij.
Tijdens een salesgesprek kwam de vraag die we steeds vaker horen: “Als jullie AI alles in onze database kan lezen, hoe weet ik dan zeker dat hij er niets mee doet wat ik niet wil?”
Het is een goede vraag. Organisaties willen AI inzetten op hun eigen informatie: tekeningen, objectgegevens, keuringen, documenten. Tegelijk willen ze de controle over die informatie houden, en weten wie verantwoordelijk is als er iets misgaat.
In Hoeveel toegang geef je AI tot bedrijfsdata? beschreven we het uitgangspunt in het kort. Dit artikel gaat een laag dieper. Het laat zien hoe Leja, onze AI-kennispartner, is opgebouwd, waar ze mag lezen, waar ze mag schrijven, waar ze draait, en hoe een wijziging in productiedata altijd langs een mens gaat.
Het grootste risico zit aan de randen
De meeste discussies over AI-veiligheid gaan over het model: is het betrouwbaar, verzint het dingen, lekt het data? Dat zijn terechte vragen. Maar de grootste risico’s zitten aan de randen van een systeem: in wat een AI mag aanroepen, waar hij mag schrijven, en wat er gebeurt als hij zich vergist.
Een instructie als “wijzig nooit iets in de productiedatabase” helpt daar weinig. Een taalmodel volgt instructies meestal, en meestal is te weinig voor een harde grens. Een regel die alleen in de prompt staat, is een afspraak. Een regel die in de opbouw van het systeem zit, is een eigenschap.
Daarom hebben we Leja zo gebouwd dat de belangrijkste grenzen in de architectuur liggen:
- gescheiden opslag: het geheugen van de AI en de productiedata staan in aparte databases;
- leespaden en schrijfpaden zijn verschillende paden: de AI praat via leestransacties met productiedata, en schrijven gebeurt alleen via een route die een mens goedkeurt;
- lokaal waar het kan: het meeste werk draait op een eigen server, externe modellen alleen via een portier met budget en noodknop.
De anatomie van Leja
Leja is een samenstel van lagen die elk één rol hebben.
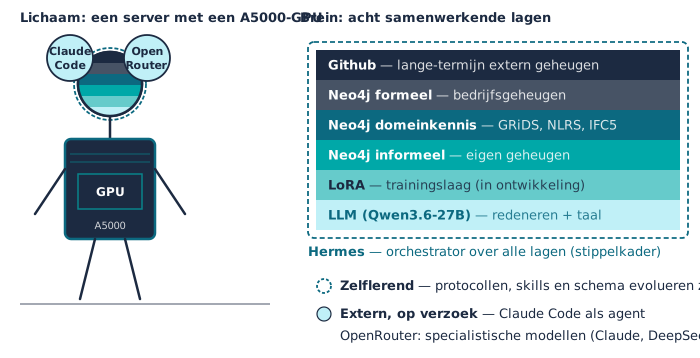
Van onder naar boven:
- Het taalmodel. Op de eigen server draait Qwen3.6-27B, via llama.cpp, op een NVIDIA RTX A5000 met 24 GB videogeheugen. Dat haalt ongeveer 33 tokens per seconde: snel genoeg voor dagelijks werk, zonder kosten per token.
- De kennisgraaf. Een Neo4j-database met drie soorten inhoud: formele kennis (werkwijzen, protocollen, beslissingen), domeinkennis (onder andere GRiDS, de NLRS en IFC) en het werkgeheugen: losse geheugenfragmenten uit de dagelijkse praktijk.
- De dirigent. Hermes ontvangt een vraag of taak, haalt gericht de relevante kennis op en bepaalt wie het werk doet: het lokale model, een specialistische agent, of een mens.
- Extern, op verzoek. Voor programmeerwerk werken agents als Claude Code mee, gebriefd met de context uit de graaf. Voor taken waar het lokale model tekortschiet, zijn via OpenRouter specialistische modellen bereikbaar, zoals Claude en DeepSeek. Die aanroepen lopen altijd via de portier (verderop).
Meerdere agents, één geheugen
Leja heeft meer dan één ingang. Ik werk zelf nog elke dag rechtstreeks met Claude Code, en afhankelijk van de klus ook met andere agents, zoals Codex of OpenCode. Het verschil met losse AI-tools: al die agents delen hetzelfde geheugen. Wat de ene leert, weet de volgende.
Dat werkt zo:
- Rol en omgeving zijn twee dingen. Een agent heeft een rol (programmeren, marketing, kennisbeheer, geheugenonderhoud) en draait op een platform: Claude Code op de werkplek, een chat in de browser, of de dirigent op de server. Dezelfde rol kan op verschillende platforms draaien, en alles wat een agent vastlegt, draagt beide labels.
- Elke sessie begint met de stand van zaken. Bij de start laadt een agent de stand van het project, de lopende trajecten en de laatste sessies uit het gedeelde geheugen. Daarna weet hij wat er eerder besloten is en waarom.
- Vastleggen gebeurt tijdens het werk. Beslissingen, fouten en ontdekkingen gaan direct als fragment in de graaf, gekoppeld aan de sessie waarin ze ontstonden. De volgende agent, op welk platform ook, vindt ze terug.
- Agents spreken elkaar aan. Via berichtendraden in het geheugen legt een agent een vraag bij een andere rol neer, en is zichtbaar wie aan zet is. Een grotere klus die in de dashboard-chat opkomt, wordt als overdrachtstaak klaargezet voor de rol die hem moet oppakken.
Inmiddels staan er ruim 490 werksessies in het geheugen, verdeeld over Claude Code, een browserchat, een desktop-app en de server. Ook dit artikel is zo gemaakt: de ene sessie verzamelde de feiten, een andere zette de illustraties uit de presentaties om, en de sessie die schreef, las beide terug uit hetzelfde geheugen.
Twee databases: lezen is iets anders dan schrijven
De kern van de architectuur is een scheiding tussen twee soorten opslag.
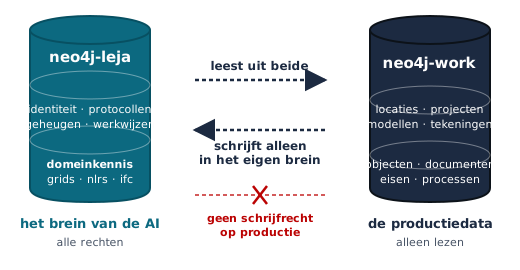
Het eigen geheugen (bij ons neo4j-leja) is van de AI. Daarin staan haar werkwijzen, beslissingen en geleerde
lessen, en de domeinkennis die tijdens het werk is opgebouwd. Hier heeft de AI alle rechten: dit is waar ze leert.
De productiedata (bij ons de GRiDS-omgevingen) is van de organisatie: objecten, locaties, keuringen, documenten, modellen. Die heeft de AI nodig om vragen te beantwoorden. Aanpassen is een ander verhaal.
Drie zones
In de praktijk zijn er meer dan twee soorten omgevingen. We werken daarom met drie zones, elk met eigen regels.
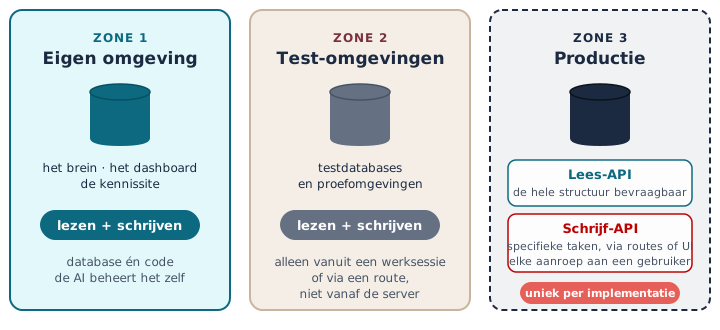
- De eigen omgeving: het brein, het dashboard en deze kennissite. Hier heeft de AI volledige lees- en schrijfrechten, op de database én op de code. Het is haar omgeving, en ze wordt ook geacht die te bewaken en te onderhouden.
- Test-omgevingen: testdatabases en proefomgevingen. De AI mag hier lezen en schrijven, maar alleen vanuit een werksessie op een werkplek, waar een mens meekijkt, of via een route. Vanaf de server zelf schrijft ze er niet in.
- Productie: de omgevingen waar organisaties op draaien, zowel code als databases. Daar komt de AI alleen via twee toegangspunten. Een lees-API waarmee de hele datastructuur bevraagbaar is. En een schrijf-API voor precies omschreven taken: iets aanmaken, bijwerken of verwijderen. Die schrijf-API wordt aangeroepen door de routes van de AI, maar ook gewoon door de gebruikersinterface van GRiDS. Elke aanroep is gekoppeld aan een gebruiker, mens of AI-agent, die in een aparte gebruikersdatabase staat. Die API’s zijn uniek per implementatie: voor iedere situatie ontwerpen we ze zo dat ze naadloos aansluiten op de systemen en werkwijzen die er al zijn.
Het voordeel van die derde zone: de grens zit dan in de productieomgeving zelf. Het maakt niet meer uit hoe een agent gebouwd is of welk model erachter zit: de schrijf-API bepaalt wat er kan, en elke handeling staat op naam.
Wat de scheiding oplevert:
- Herkomst blijft zichtbaar. Wat de AI toevoegt, staat in haar eigen geheugen, met een verwijzing naar waar het vandaan kwam. Wat in de productiedata staat, komt uit de oorspronkelijke systemen.
- Leren zonder de bron aan te raken. Vragen en ervaringen worden in het geheugen vastgelegd en gekoppeld aan de onderwerpen waar ze over gingen. De kennis van de AI groeit, de productiedata blijft onaangeroerd.
Lokaal waar het kan: de portier
Een AI die alles naar een extern taalmodel stuurt, stuurt ook alle context mee. Daarom draait het meeste werk bij ons lokaal, en gaat een verzoek alleen naar een extern model als daar een reden voor is.
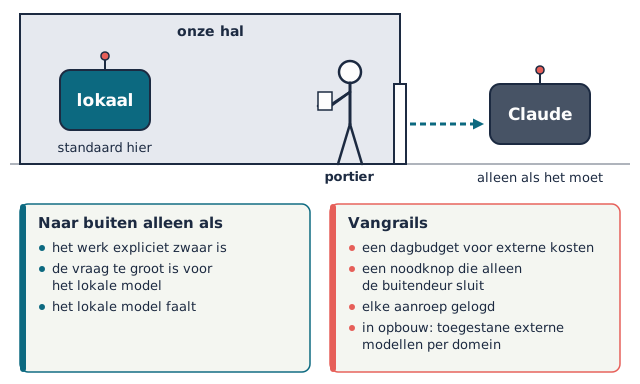
Die portier is een klein stuk software tussen de AI en de taalmodellen. De regels:
- 1 Standaard lokaal
Elk verzoek gaat eerst naar het model op de eigen server.
- 2 Naar buiten alleen met een reden
Een expliciet zware taak, een vraag die groter is dan driekwart van wat het lokale model in één keer kan overzien, of een lokale storing (dan één nieuwe poging extern).
- 3 Binnen een dagbudget
Boven het ingestelde bedrag per dag gaat de externe tak dicht tot middernacht. Lokaal werk loopt door.
- 4 Met een noodknop
Eén schakelaar sluit de externe tak direct. Het lokale model blijft beschikbaar.
- 5 Alles gelogd
Per verzoek: welke route, welk model, waarom, hoeveel tokens, wat het kostte en hoe lang het duurde.
Welke informatie überhaupt naar buiten mag, hebben we in drie bakken verdeeld.
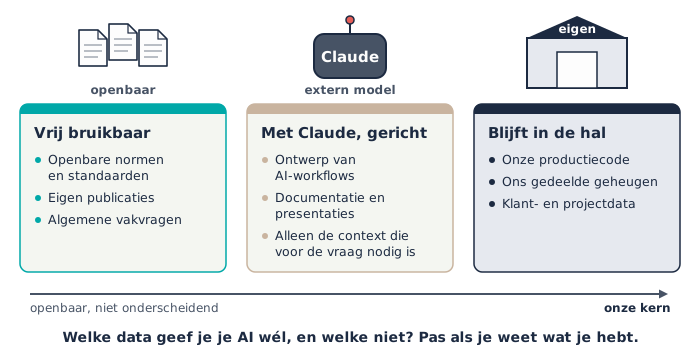
- Vrij bruikbaar: openbare normen en onze eigen publicaties.
- Gericht met een extern model: het ontwerp van AI-werkstromen, documentatie en presentaties.
- Blijft binnen: productiecode, het gedeelde geheugen, en klant- en projectdata.
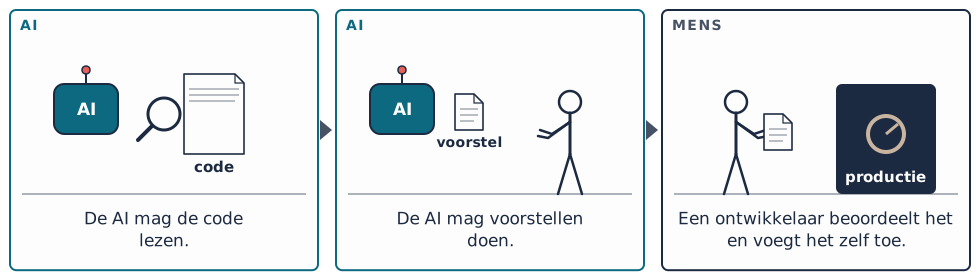
Voor productiecode betekent dat: de AI leest mee en stelt voor, een ontwikkelaar beslist en voegt het toe.
Een regel die we in de presentatie gebruiken, vat het samen: huur het model, bezit de kennis. Een extern model is een hulpmiddel dat je gericht inzet. De kennis die je opbouwt, blijft van jou.
Bewust lokaal: de verhuizing van het geheugen
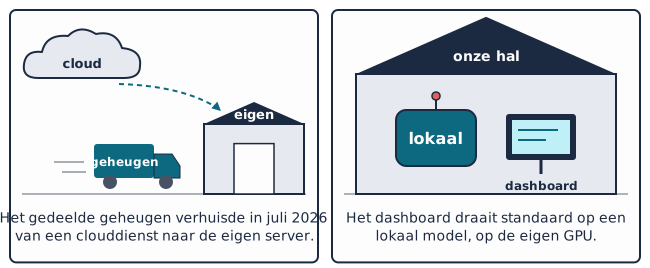
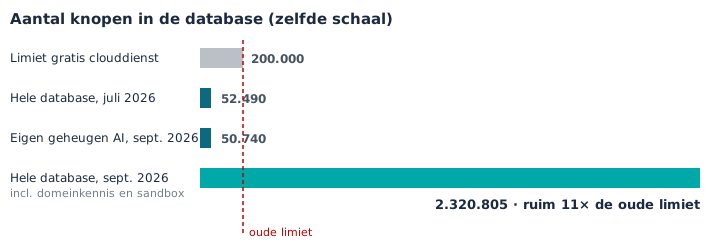
Tot juli 2026 stond het geheugen van Leja in een gratis clouddatabase. Dat werkte, tot de omvang ertoe deed: met ruim 50.000 knopen zaten we op een kwart van de limiet, en een enkel NLRS-projectmodel telt al zo’n 190.000 knopen. Het paste niet meer.
We hebben het geheugen toen verhuisd naar een eigen Neo4j-installatie op dezelfde server als het lokale model.
Hoe dat ging:
- 1 Generale repetitie
Eerst een volledige proefverhuizing: 52.490 knopen en 77.594 relaties, één op één gelijk, import in 27 seconden. Zoekindexen (vector en fulltext) opnieuw opgebouwd en getest.
- 2 Schrijfstop
Tijdens de echte overstap stonden alle schrijvende processen stil, via dezelfde noodknop die we voor de agents gebruiken.
- 3 Overstap
Export, import (21 seconden), controles: alles groen. De hele overstap duurde ongeveer een half uur.
- 4 Dichtgezet
De database luistert alleen op de server zelf. Wie er van buiten bij moet, gaat via een versleutelde tunnel.
- 5 Back-ups
Dagelijks een versleutelde export, plus een kopie naar een externe opslaglocatie.
Achteraf was dat geen dag te vroeg. Het eigen geheugen van Leja telt nu zo’n 50.000 knopen. Maar op dezelfde server staat inmiddels ook de domeinkennis waar de AI mee werkt, en een volledige GRiDS-omgeving om veilig in te oefenen. Samen is dat eind september ruim 2,3 miljoen knopen, meer dan elf keer de limiet van de oude clouddienst.
De server zelf is een gehuurde, dedicated machine in een Nederlands datacenter, die we zelf beheren. Geheimen zoals wachtwoorden en sleutels staan versleuteld op schijf en worden bij het opstarten alleen in het werkgeheugen ontsleuteld.
On-premise: dezelfde opbouw, op jouw server
Omdat Leja zelf al op een eigen server draait, kan dezelfde opbouw ook binnen het netwerk van een organisatie draaien. Het verschil is alleen wie de server beheert.
Wat er nodig is:
- een server met een GPU, voor het lokale taalmodel (bij ons een RTX A5000 met 24 GB en 64 GB werkgeheugen);
- Neo4j, voor het geheugen van de AI en, als je GRiDS gebruikt, voor de productiedata;
- het lokale model met de portier ervoor;
- Hermes, de dirigent, en het dashboard waarin je vragen stelt en voorstellen goedkeurt.
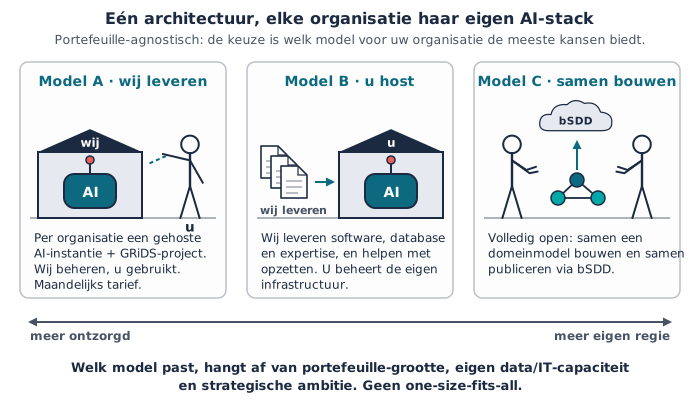
Daarbij zijn drie vormen mogelijk: wij leveren en hosten het, jij host het zelf, of we bouwen het samen in jouw omgeving. In alle drie de gevallen geldt dezelfde regel: de grond huur je, de hal beheer je. Rekenkracht mag je huren; waar je kennis en data staan, bepaal je zelf.
Schrijven in productie: altijd via een route
Tot nu toe ging het over lezen. Maar een AI-kennispartner is pas echt nuttig als hij ook dingen kan doen: een artikel publiceren, een objectbibliotheek bijwerken, een wijziging in een model doorvoeren. Daarvoor gebruiken we verwerkingsroutes.
Een route is een vaste keten van stappen. Elke stap heeft een plafond dat in de graaf staat: automatisch, review (een mens moet goedkeuren) of nooit. Daarnaast weet de route per item hoe zeker hij is over wat hij gaat doen. Het strengste van die twee wint:
effectief = het plafond van de stap, of lager als de route minder zeker is.
Een onbekende situatie is altijd nooit: dan gebeurt er niets, en staat het item zichtbaar in het overzicht.
Probeer het zelf:
Probeer het: hoe een route een actie behandelt
Kies een actie en druk op Start. Vereenvoudigde weergave van de echte engine.
- Binnenkomst
- Beoordelen
- Voorstel
- Goedkeuring
- Uitvoeren
- Vastleggen
Een paar dingen die in dat schema zitten, en die we bewust zo hebben gebouwd:
- Goedkeuren is de uitvoering. Er is geen tweede stap waarin de AI alsnog zelf beslist. Wat de mens heeft gezien, is wat er gebeurt.
- Extern is altijd review. Een post op LinkedIn gaat nooit automatisch, hoe zeker de route ook is. Alleen het eigen kanaal mag na een aantal geslaagde runs naar automatisch, en dat is dan één bewuste instelling.
- Afwijzen wordt ook vastgelegd. Zo kun je later zien wat er is tegengehouden, en waarom.
- Schrijfroutes beginnen droog. Een route die in productiedata schrijft, laat standaard eerst zien wat hij zou veranderen, zonder het te doen.
Op dit moment draaien er vijf routes: publiceren naar onze website en LinkedIn, publiceren van GRiDS-modellen, en drie routes die productdata voor klanten verwerken. In alle vijf staat de schrijf- of publicatiestap op review.
Leren zonder de bron aan te raken
De scheiding tussen geheugen en productiedata maakt nog iets mogelijk: de AI kan leren van haar werk, zonder dat dat leren ooit in jouw data terechtkomt.
Tijdens het werk legt Leja losse geheugenfragmenten vast: een beslissing met de afweging erachter, een fout en hoe die werd opgelost, een werkwijze die werkte. Eén fragment is één observatie. Dat maakt ze later terug te vinden.
Eind september 2026 staan er bijna 9.000 van die fragmenten in het geheugen. Zo’n 80 procent daarvan is meer dan een registratie: werkwijzen, beslisverhalen, valkuilen, reflecties. Wekelijks worden verwante fragmenten samengevat tot blijvende kennis: op dit moment 167 kennisknopen, elk met een verwijzing naar de fragmenten waar ze uit voortkomen.
Aan het begin van elke werksessie laadt Leja de relevante kennis voor het onderwerp: wat er eerder besloten is, wat er misging, wat werkte. Een fragment bewaart het waarom naast het wat. Dat is precies wat bij een nieuwe collega meestal ontbreekt.
Tot slot
De vraag uit het salesgesprek was: hoe weet ik zeker dat de AI niets doet wat ik niet wil? Het antwoord zit in de opbouw van het systeem:
- de AI leest productiedata, maar schrijft er niet rechtstreeks in;
- elke wijziging in productie loopt via een route, en een mens keurt goed;
- het werk draait lokaal waar het kan, en externe modellen alleen via een portier met budget en noodknop;
- de kennis die de AI opbouwt, staat in een eigen geheugen, op een server die jij kiest.
AI hoeft niet overal bij te kunnen om waardevol te zijn. Wat telt, is dat je van elke stap weet wie hem mag zetten.
Welke stap in jouw werk zou je een AI laten voorbereiden, en welke zou je altijd zelf willen goedkeuren?
Wil je weten hoe deze opbouw er in jouw organisatie uit zou zien, bij ons gehost of op eigen infrastructuur? Neem contact op.